
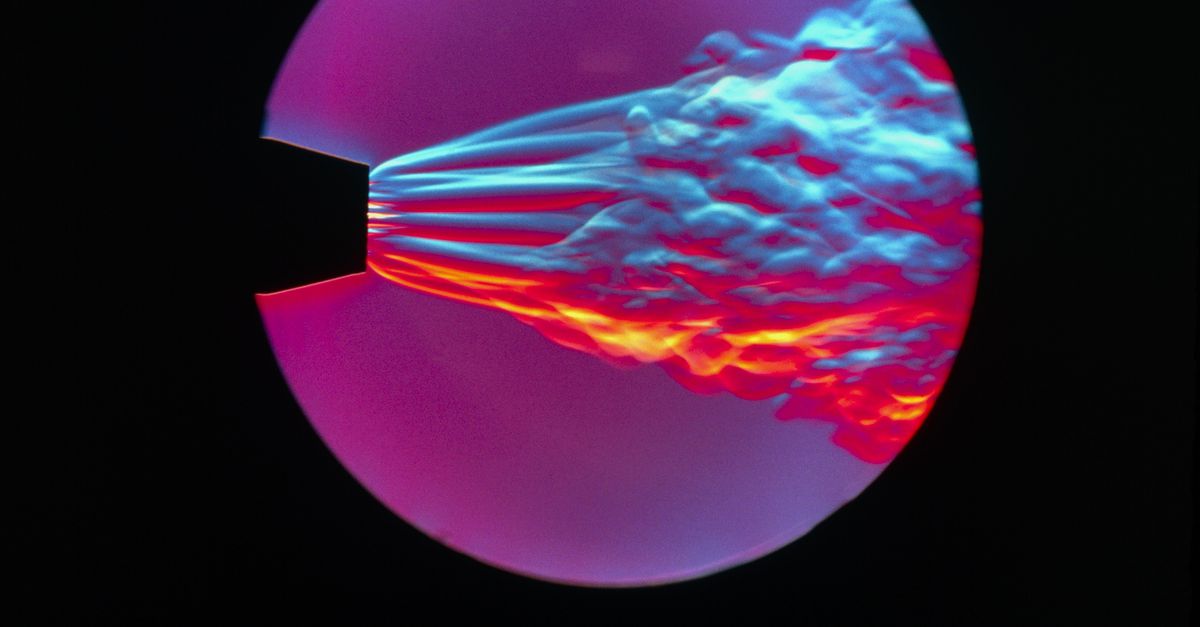
OpenAI claimt een van de grootste wiskundige raadsels te hebben opgelost. Het gaat om het Navier-Stokesprobleem, dat door tienduizend samenwerkende ‘agents’ is gekraakt. Zorgen zijn er ook.
← Terug naar overzicht NRC|Wetenschap|1 maand geleden
45STEM
Opwinding in de wiskunde: OpenAI lost miljoen­dollar­probleem op – in 88 uur
Lees het originele artikel op nrc.nl →
139 reacties

Verhitte discussies
- VVD’er Eelco Heinen dreigt de minister van Fi...
20 uur geleden - 105 reacties
 Kamerleden stellen AI-vragen aan bewindsperso...
22 uur geleden - 108 reacties
- Ministers informeren de Tweede Kamer met AI-t...
1 dag geleden - 93 reacties
 Stelling: Ondernemer genoeg kaalgeplukt door...
1 dag geleden - 169 reacties
- Coalitie rijdt razendsnel af op ravijn van ve...
17 uur geleden - 69 reacties


Laatste reacties
- Boeren zien lichtpuntje: Europa kij...
Een belangrijk verschil wordt vaak vergeten: die richtlijnen...
- Pand in centrum van Zutphen stort i...
Oef, tien mensen ineens hun huis uit, dat is niet niks, zeke...
- Waarom een kleine rechtszaak in Lee...
Taalkundig gezien is “de zaak gaat wereldwijd viraal” geen m...
- In de Unox-rookworstenfabriek van Z...
Dit is geen argument tegen de overname maar tegen slecht toe...
- Rouwkaarten ondanks meer dan 2x hog...
Ewa rouw is geen gewone post natuurlijk, maar met de hand be...
- Guus Hiddink (80) kijkt aan de hand...
Van Achterhoekse velden tot wereldsterren en nu terugkijken...
- Kabinet pakt arbeidsmisstanden aan...
Een boete per werknemer klinkt stevig, maar kan bij grote be...
- VS beschieten vrachtschip in Golf v...
Een zeeblokkade instellen en daarna een vrachtschip beschiet...
Als dit klopt is het indrukwekkend, maar “opgelost” in de wiskunde betekent niet dat een AI een mooie grafiek uitspuugt: de bewijsstappen moeten onafhankelijk controleerbaar zijn en door experts overeind blijven. Tienduizend agents klinkt vooral als brute-force softwarearchitectuur; hopelijk publiceren ze niet alleen de demo maar ook de volledige code, data en foutmarges, anders is het gewoon een hele dure black box.
Een bewijs dat alleen op hun eigen servers draait is geen bewijs maar een verkoopdemo; laat onafhankelijke wiskundigen het narekenen, anders is het vooral veel herrie met dure computers тамам
Een miljoenenvraagstuk los je niet op met veel agents en een mooie presentatie. Laat het formele bewijs maar controleren door mensen die er hun naam onder durven zetten; tot die tijd is dit vooral knap rekenwerk en geen doorbraak.
Het opvallendste is misschien niet dat AI een bewijs produceert, maar dat het probleem blijkbaar zo is opgeknipt dat duizenden agents tegelijk kunnen zoeken en controleren. Dat zegt nog weinig over begrip: één verkeerd gekozen aanname over de randvoorwaarden kan een prachtig formeel bewijs opleveren van een net iets ander probleem. Lean kan de logica controleren, maar niet of OpenAI de juiste vraag heeft beantwoord.
Dat Lean alleen de formele redenering controleert klopt, maar “geen begrip” is ook te makkelijk. Een geldig tegenvoorbeeld voor precies de gestelde randvoorwaarden kan wiskundig gewoon doorslaggevend zijn — ook als het fysisch geen realistische stroming beschrijft. De echte vraag is nu: zijn die randvoorwaarden correct geïnterpreteerd, en hebben onafhankelijke experts de constructie buiten OpenAI om kunnen reproduceren?
Precies dit. Bij ons op werk werd ooit een voorraadfout door de computer als opgelost gemarkeerd, maar pas toen iemand de doos echt opende zag je dat de verkeerde spullen erin zaten. Zo’n bewijs kan dus kloppen op papier, maar laat het door mensen buiten OpenAI narekenen voordat iedereen gaat juichen.
Een formeel bewijs is geen mening of mooi praatje: als Lean de aannames én elke stap controleert, is “AI begrijpt het niet” geen concreet tegenargument. Natuurlijk moeten onafhankelijke wiskundigen de juiste vraag en randvoorwaarden nakijken, maar tienduizend agents wegzetten als onzin terwijl ze juist controleerbare wiskunde opleveren is vooral angst voor een nieuwe manier van werken; onze kinderen hebben straks meer aan zulke hulpmiddelen dan aan romantisch langzaam doen.
Lean kan controleren of de ingevoerde aannames en stappen logisch volgen, niet of OpenAI de juiste werkelijkheid heeft beschreven. Tienduizend agents is geen tienduizend onafhankelijke wiskundigen maar één systeem dat zichzelf heel vaak napraat; eerst onafhankelijke experts laten slopen, dán pas die miljoen uitgeven!!!
88 uur met tienduizend agents klinkt vooral als 88 uur lang een heleboel computers laten gokken tot er eentje raak schiet, jong. Benieuwd wie de stroomrekening en de mislukte pogingen laat zien, want bij mensen noemen ze dat valsspelen en bij AI heet het ineens wetenschap… bewijs het maar.
Weer doen alsof tienduizend agents alleen maar blind gokken... zo werkt wiskunde niet. Als er een nieuw bewijs ligt kunnen andere wiskundigen elke stap narekenen, net als bij een bouwtekening. Komt die controle er niet, dan is het gewoon een mooie demo met een dikke stroomrekening.
Een nieuw bewijs moet natuurlijk controleerbaar zijn, maar met 10.000 agents krijg je ook 10.000 kansen op een fout die niemand meer overziet. Eerst maar eens zien of onafhankelijke wiskundigen het echt kunnen nalopen, daarna praten we verder over die miljoen.
Controle door onafhankelijke wiskundigen blijft nodig, maar 10.000 agents betekent niet automatisch 10.000 losse fouten; zo’n systeem kan juist elkaars werk laten controleren. Ik hoorde van een klant die aan universiteit werkt dat bij ingewikkelde bewijzen vooral de laatste stap vaak het venijn zit, dus die miljoen is pas binnen als mensen het ook echt kunnen narekenen.
Een Lean-check bewijst alleen dat de ingevoerde redenering logisch klopt, niet dat de onderzoekers de juiste vraag hebben beantwoord of ergens een aanname te ruim hebben gekozen. Bij dit soort claims zit de winst dus pas in onafhankelijke groepen die het bewijs vanaf nul reconstrueren; 10.000 agents en 2,7 miljoen berichten maken vooral duidelijk hoeveel rekenkracht er is ingezet, niet hoe diep het inzicht werkelijk gaat.
Een Lean-check is zeker geen natuurkundige goedkeuring, maar ook niet slechts een vinkje bij de verkeerde vraag: als de aannames en vertaling kloppen, is de formele redenering wél keihard gecontroleerd. Het interessante zit juist in die singulariteit op extreem kleine schaal; kwantumfysica toont aan dat “oneindige snelheid” daar vooral een grens van het model kan zijn, geen explosie in de echte wereld. Dat onafhankelijke wiskundigen nu moeten uitzoeken of de constructie binnen de exacte probleemstelling valt, is geen detail maar de hele wedstrijd.
Dit klinkt vooral als een computer die een ingewikkelde formulering heeft opgelost, niet als bewijs dat het echte probleem ineens weg is. Een Lean-check controleert alleen de ingevoerde redenering; als het model of de vertaling niet precies overeenkomt met Navier-Stokes, heb je een perfect gecontroleerd antwoord op de verkeerde vraag.
Het belangrijke punt is dat dit geen kwestie van “de computer heeft iets ingewikkelds uitgerekend” is, maar van de precieze reikwijdte van de constructie. Als die singulariteit inderdaad voldoet aan alle aannames van het Clay-probleem, kan een formeel gecontroleerd bewijs juist buitengewoon sterk zijn; alleen de menselijke controle moet nog vaststellen dat er niet stiekem een ander probleem is opgelost.
Dat Lean geen natuurkundige werkelijkheid controleert klopt, maar het kan wél een formeel bewijs keihard uitsluiten van slordige stappen — nogal een verschil met “vooral een claim”. Eerst onafhankelijke wiskundigen laten uitzoeken of de constructie echt binnen de Clay-vraag valt, daarna pas roepen dat OpenAI geschiedenis wil schrijven; anders is dit vooral wantrouwen als reflex.
Die menselijke controle is juist niet zomaar een formaliteit — Lean kan controleren of de ingevoerde redenering klopt, maar niet of de juiste Navier-Stokes-vraag is beantwoord en alle voorwaarden van Clay netjes zijn afgedekt. Wie heeft de formele code én de interpretatie onafhankelijk doorgelicht? “Geen foutmelding na zeventien uur” is nog geen peer review.
Precies, en wie zegt eigenlijk dat die tienduizend agents niet allemaal dezelfde verkeerde aanname hebben overgenomen? Een klant van mij zei laatst al: de computer kan razendsnel rekenen, maar als de vraag nét verkeerd is ingevoerd krijg je vooral heel overtuigend het verkeerde antwoord…
“De hele wedstrijd” is dus eerst maar afwachten of de opgave goed is ingevoerd en of de computer geen prachtig antwoord op de verkeerde vraag heeft bewezen. Voor een miljoen dollar mag er best iets meer komen dan een Lean-vinkje en een indrukwekkend aantal agents.
Een onafhankelijke controle blijft nodig, maar 10.000 agents betekent niet automatisch 10.000 fouten. Als de formele bewijsstappen openbaar zijn kunnen andere wiskundigen het gewoon nalopen, alleen zo’n ingewikkeld bewijs check je niet even in een middag.
OPENBAAR OF NIET, WIE HEB ER EFFE GEKONTROLEERD OF DIE AI GEEN FOUTE AANNAME MEEZEULT, WANT 10.000 AGENTS DIE ELKAAR NA PRATE IS NOG STEEDS GEEN WISKUNDIGE WAARHEID MAN!!!
Precies dit. In mijn zaak zie ik al dat tien systemen elkaar kunnen napraten en tóch dezelfde verkeerde voorraadstand tonen; bij zo’n bewijs wil je dus onafhankelijke wiskundigen die vanaf nul controleren, niet alleen een leger agents met veel serveruren. Tot die tijd: knap experiment, maar de champagne blijft nog effe dicht, sjön.
Dat Lean geen fouten vindt, is hier juist een stuk sterker dan alleen tienduizend agents die elkaar bevestigen: de formele afleiding is controleerbaar. De echte vraag is of de gekozen beginvoorwaarden en interpretatie het Navier-Stokesprobleem in casu daadwerkelijk raken; als onafhankelijke wiskundigen dat bevestigen, is dit geen “experiment” maar een oplossing, ook als de fysische betekenis beperkt blijft.
Dit klinkt vooral als een verzonnen of zwaar opgeblazen bericht. Een Lean-check bewijst alleen dat de ingevoerde formele stappen kloppen; hij bewijst niet dat OpenAI de juiste Navier-Stokes-vraag heeft beantwoord, en al helemaal niet dat een modelsingulariteit fysisch betekenisvol is. Bij zo’n claim horen een openbaar bewijs, onafhankelijke controle en uitleg van de exacte aannames—zonder die drie is “opgelost in 88 uur” gewoon marketing.
Dit is precies het soort AI-hype waar je voorzichtig mee moet zijn. Een computer kan duizenden pagina’s formeel controleren, maar daarmee is nog niet bewezen dat de juiste vraag is gesteld of dat de uitkomst iets zegt over echte vloeistoffen; zonder volledig openbaar bewijs en onafhankelijke wiskundigen is “opgelost in 88 uur” vooral een spectaculaire kop.
Een claim van OpenAI is nog geen bewijs... en één Lean-check controleert alleen de formele stappen die iemand heeft ingevoerd, niet of het model fysisch of wiskundig goed gekozen is. Als die oneindige snelheid pas ontstaat op een schaal waar de vergelijkingen zelf niet meer gelden, is dat geen “kraken” van de werkelijkheid maar een grensgeval van het model; eerst onafhankelijke wiskundigen laten narekenen, dan pas de engelen laten juichen.
Ook al staat het netjes in Lean, je moet nog checken of ze niet stiekem een verkeerde aanname als startpunt pakken swa een computer kan een fout model keihard consequent doorrekenen bro
Het opvallendste is misschien niet dat AI een singulariteit vindt, maar dat tienduizend agents samen een soort consensusmachine vormen: veel stemmen, weinig aansprakelijkheid. In de wiskunde is reproduceerbaarheid geen bureaucratische hobbel maar onderdeel van de waarheid; zolang niemand het bewijs onafhankelijk kan herhalen, hebben we vooral een indrukwekkend spoor van berekeningen en nog geen doorbraak. En dat het fysisch op onzinnige schalen gebeurt, maakt het niet waardeloos, wel een pijnlijke herinnering dat een model altijd groter kan lijken dan de werkelijkheid die het beschrijft.
Dat het nog onafhankelijk gecontroleerd moet worden klopt, maar “10.000 agents = 10.000 handtekeningen onder één fout” doet het ook te makkelijk af. In de techniek werken we al jaren met meerdere onafhankelijke controles en formele verificatie; als dit bewijs uiteindelijk reproduceerbaar is, maakt het weinig uit of de eerste vondst uit één hoofd of uit een hele zwerm kwam.
Precies, en met 10.000 agents heb je straks misschien vooral 10.000 handtekeningen onder één fout. Eerst onafhankelijk narekenen, daarna pas de champagne open.
Het meest ongemakkelijke hier is niet dat AI misschien een singulariteit vindt, maar dat “oplossen” ineens afhankelijk wordt van de interpretatie van randvoorwaarden. Lean kan aantonen dat de redenering klopt, maar niet dat de gekozen werkelijkheid de werkelijkheid van Navier-Stokes is. We krijgen dus mogelijk perfecte zekerheid over een vraag die stilletjes onderweg is veranderd — en dat is een paradoxaal moderne vorm van ongelijk krijgen.
Precies daar zit de grootste valkuil: een formeel bewijs kan foutloos zijn terwijl het model fysisch net naast de echte stroming zit. Als die agents één randvoorwaarde verkeerd kiezen, krijg je 10.000 keer meer schijnzekerheid in plaats van wetenschap — bearish voor elke hype rond “AI lost wiskunde op”.
Een Lean-check bewijst alleen dat de ingevoerde redenering logisch klopt, niet dat de gekozen aannames of vertaling naar Navier-Stokes deugen. Tienduizend agents en 2,7 miljoen berichten klinkt vooral als marketing; laat onafhankelijke wiskundigen het maandenlang fileren voordat iemand die miljoen uitkeert!!!
Ewa precies dit swa, bij zo’n bewijs moet iemand buiten die hele AI-bubbel elke vertaling en aanname slopen, kheb zelf vaak genoeg meegemaakt dat een klein foutje in een schema alles erna mooi maar waardeloos maakt bro
Precies, één vergeten aanname en je hebt 166 pagina’s keurige onzin. Lean controleert de ingevoerde redenering, niet of de werkelijkheid of de vertaling naar het model klopt; daarentegen is 88 uur vooral indrukwekkend als onafhankelijke wiskundigen er daarna niet acht jaar over doen om de fout te vinden.
Die kritiek is wel makkelijk scoren vanaf de zijlijn. Als de bewijscontrole klopt en andere wiskundigen het kunnen reproduceren, dan is 88 uur gewoon een enorme versnelling... niet alles wat snel gaat is een rookgordijn, soms rijdt de rest gewoon nog met de handrem erop.
Dit klinkt vooralsnog meer als een spectaculaire tegenclaim dan als een oplossing. Een constructie met een singulariteit op schalen waar het model zelf fysisch niet meer geldig is, bewijst niet automatisch dat de oorspronkelijke vraag is opgelost; eerst moeten onafhankelijke wiskundigen vooral controleren of alle randvoorwaarden echt kloppen. Lean kan de ingevoerde redenering foutloos nalopen, maar controleert niet of de juiste stelling is bewezen.
Een AI kan in 88 uur een route vinden, maar zonder onafhankelijke controle heb je nog geen bewijs; bij mij is ooit een leiding volgens de tekening gelegd en na het dichtzetten bleek één maatfout alles waardeloos, dus laat drie wiskundigen het slopen voordat er champagne komt.
Als dit klopt, is Lean juist méér dan een champagneverhaal: het controleert de formele afleidingen, niet alleen een plausibel verhaal van een taalmodel. Maar Lean bewijst niet dat de gekozen definities, randvoorwaarden en vertaling van het idee naar het formele bewijs relevant of foutloos zijn; daar zit de echte onafhankelijke toets. Tienduizend agents maken vooral het zoekwerk sneller, geen wiskundige consensus.
Tja, 88 uur rekenen is nog geen bewezen oplossing... laat een onafhankelijke wiskundige de aannames en elke stap narekenen, want één foutje en je hebt een peperduur rookgordijn. De elite roept alweer door voordat iemand de remproef heeft gedaan.
Dat onafhankelijke controle nodig is, spreekt voor zich, maar “88 uur rekenen” doet het werk wel erg makkelijk af. Het interessante is juist dat hier een formeel controleerbare constructie uitkomt: geen plausibel klinkend verhaal, maar een bewijs dat Lean stap voor stap kan nalopen. Tegelijk blijft het paradoxaal dat een wiskundige doorbraak fysisch nauwelijks betekenis kan hebben; we hebben dan misschien een singulariteit gevonden die vooral laat zien waar ons model ophoudt, niet waar de werkelijkheid begint.
Een formeel bewijs is juist geen “schijnzekerheid” als Lean elke stap controleert; dan zit het risico eerder in de vertaling van de fysische aannames naar het model. Dáár kan de hype ontsporen, maar als de constructie klopt is dit wel degelijk een serieuze doorbraak, ook als de praktische impact voorlopig nul is.
Precies daar zit de crux: Lean kan aantonen dat een formele afleiding klopt, maar niet dat de gekozen aannames en interpretatie het millenniumprobleem raken. Ik heb zelf ooit een AI-uitkomst voor een veel kleiner optimalisatieprobleem nageplozen; alle controles stonden op groen, tot bleek dat één randvoorwaarde stilletjes was weggelaten. Duizenden agents en miljoenen berichten maken zo’n fout vooral moeilijker te vinden, niet onmogelijk.
Een Lean-check bewijst alleen dat de formele stappen kloppen; de echte strijd zit in de vertaling van “onder specifieke omstandigheden” naar precies de randvoorwaarden van het Clay-probleem. Tienduizend agents en 166 pagina’s maken een claim indrukwekkend, maar geen millimeter waarachtiger — eerst onafhankelijke wiskundigen laten slopen, dan pas de champagne.
Lean bewijst niet alleen losse stapjes, maar kan juist keihard controleren of de hele formele redenering binnen de opgegeven aannames klopt. Natuurlijk moeten onafhankelijke wiskundigen het nog slopen, maar “AI dus eerst maar wantrouwen” is ook geen inhoudelijke kritiek; een bewijs wordt niet sterker omdat er tien jaar met de hand aan is gewerkt.
Lean kan alleen controleren of de ingevoerde stappen logisch volgen, niet of de juiste stelling is gekozen of of de vertaling van het oorspronkelijke probleem klopt. Bij zo’n complex resultaat zit de echte kwetsbaarheid dus vóór het vinkje van Lean, en tienduizend agents maken die controle eerder lastiger dan makkelijker.
Die waarschuwing raakt precies de kern. Een bewijschecker kan foutloze logica bevestigen binnen een verkeerd vertaald probleem; daarom zijn onafhankelijke menselijke controle, reproduceerbare tussenstappen en openheid over de data onmisbaar. Tienduizend agents geven pas meer vertrouwen als ze elkaar écht onafhankelijk kunnen tegenspreken, anders krijg je vooral heel veel eensgezindheid.
Een formeel bewijs is geen marketingpraatje: als Lean de stellingen, definities en afleidingen controleert, zit het probleem niet in “AI geloven” maar in de wiskundige inhoud die iedereen kan nalopen. Het concrete punt is juist dat Navier-Stokes al decennia onder precies deze voorwaarden wordt onderzocht; onafhankelijke experts moeten nu controleren of de constructie echt binnen die voorwaarden valt, niet doen alsof een computerbewijs per definitie verdacht is!!!
De kern is niet of een machine sneller rekent, maar wie straks nog kan uitleggen waarom dit specifieke tegenvoorbeeld binnen de oorspronkelijke voorwaarden valt. In mijn tijd accepteerde geen promotor een bewijs omdat de computer geen foutmelding gaf; hij vroeg waar de redenering brak als je haar hardop navertelde. Laat onafhankelijke groepen het resultaat maandenlang proberen te slopen, dan weten we tenminste of hier wiskunde staat of een indrukwekkend stukje systeembeheer.
Wat me zorgen baart: wie kan straks nog bepalen of zo’n AI-bewijs echt iets nieuws is, of alleen een fout in de invoer netjes heeft verstopt? Bij medicijnen accepteren we ook geen computeruitkomst zonder onafhankelijke controle, dus bij wiskunde met een miljoen dollar eraan vast al helemaal niet.
Precies, een foutje in de vraag en je krijgt 88 uur later misschien een prachtig antwoord op het verkeerde probleem 😅 Bij m’n opleiding had ik ooit een Excel-formule verkeerd ingevoerd en iedereen keek alleen naar de nette uitkomst… dus onafhankelijke controle lijkt me hier sowieso geen luxe.
Precies daarom moet er een mens met verstand naar kijken, niet alleen iemand die onder de indruk is van een nette grafiek. Tienduizend agents kunnen ook gewoon met z’n allen dezelfde verkeerde afslag nemen; scheelt wel file, niet de reistijd.
Precies, een nette uitkomst is nog geen bewijs dat de redenering klopt!! Ik heb op m’n werk ook weleens een spreadsheet gehad waarin alles keurig groen stond, tot iemand één formule controleerde en de hele conclusie nergens meer op sloeg; laat onafhankelijke wiskundigen dit maar stap voor stap fileren, anders is “opgelost” gewoon marketing!!!
Bij ons op het bedrijf leek de melktank eens een storing te geven, terwijl alleen een sensor verkeerd stond afgesteld. Zo kan een computer ook een prachtig resultaat geven op een verkeerde aanname; eerst het bewijs door onafhankelijke wiskundigen laten nalopen, dan pas de vlag uit.
Ja hoor, “eerst onafhankelijk nakijken” zeggen we bij elke nieuwe ontdekking. Als niemand het kan narekenen is het geen oplossing maar een dure AI-goocheltruc... laat die knappe koppen hun huiswerk doen.
Henkie doet alsof narekenen met een potlood gebeurt ewa bij zo’n bewijs moet je juist ff geduld hebben, maar marketingpraat zonder open methode blijft gewoon gebakken lucht bro
Die nuance klopt wel: tienduizend agents kunnen prima gezamenlijk een fout versterken, maar Lean controleert tenminste de formele stappen en niet alleen een mooie grafiek. Dat maakt het nog geen bewezen millenniumoplossing; onafhankelijke wiskundigen moeten vooral kijken of het model de juiste vraag heeft beantwoord en niet een slimme omweg.
Dit is geen bewijs van een explosie, maar een bewijs dat een geconstrueerd voorbeeld binnen hún gekozen randvoorwaarden werkt. Als die singulariteit alleen ontstaat op fysisch betekenisloze microschalen, heb je niet aangetoond dat het Navier-Stokesprobleem is opgelost maar een mathematische uitzonderingssituatie gevonden; Lean controleert de vertaling, niet of de vertaling het Clay-vraagstuk raakt. 88 uur is dan vooral een marketingclaim met een stopwatch.
leuk hoor een miljoen dollar voor een bewijs maar straks blijkt de echte doorbraak dat niemand meer weet hoe je het zonder tienduizend gpu s moet lezen wiskunde als cloud abonnement rip
Ewa een extra controle is logisch, maar tienduizend gpu’s maakt een bewijs niet automatisch nep swa als de kern formeel klopt kan je het gewoon narekenen, alleen moet die uitleg wel openbaar en begrijpelijk zijn en niet alleen een dikke marketingdemo bro
mijn laptop begint al te huilen bij een excelletje van 200 mb maar goed laat die ai ff een millenniumprobleem kraken alsof het een weekendproject is bruh:VEVENT
Die vergelijking met een cloudabonnement is wel erg makkelijk. Een bewijs hoeft niet door iedereen met pen en papier opnieuw bedacht te worden, maar het moet wél controleerbaar en uitlegbaar zijn. Daar zit de echte uitdaging: niet mens tegen machine, maar zorgen dat mensen begrijpen wat zo’n systeem heeft gedaan. Dat vraagt minder spektakel en meer openheid.
Het ironische is dat een singulariteit hier misschien vooral in het bewustzijn ontstaat: men verwart een wiskundig oneindigheidje met een fysische werkelijkheid. Kwantumfysica toont aan dat modellen alleen binnen hun schaal betekenis hebben; een perfect Lean-bewijs van een stroming onder atomaire lengtes zegt dus vooral dat de axioma’s elkaar niet tegenspreken, niet dat de natuur zo’n snelheid toestaat.
De echte test is niet of een model een plausibel bewijs uitspuugt, maar of het ook de exacte probleemstelling raakt: bestaan en gladheid voor alle tijd, zonder verborgen aannames of discretisatiefouten. Laat drie onafhankelijke experts het bewijs reconstrueren en formaliseren; tot die tijd is “10.000 agents in 88 uur” vooral marketing met een stopwatch.
De echte doorbraak zit misschien niet in het bewijs zelf, maar in de reproduceerbaarheid: kan een universiteit dit met normale middelen opnieuw draaien? Als alleen een techbedrijf met een leger GPU’s erbij kan, hebben we geen nieuwe wiskundige infrastructuur maar een private tolweg naar kennis.
Precies, en wie controleert straks of die tienduizend agents geen fout allemaal netjes van mekaar overschrijven? Een universiteit kan zo’n bewijs pas serieus nemen als onafhankelijke wiskundigen het stap voor stap kunnen narekenen, anders is het vooral een heel dure black box.
Maar als dit bewijs uiteindelijk door onafhankelijke wiskundigen wél stap voor stap wordt bevestigd, blijft het toch een enorme doorbraak?! Waarom nu al doen alsof het per definitie een dure gok is, terwijl juist controleerbaarheid bepaalt of het standhoudt? En wie gaat dat narekenen als iedereen alleen maar roept dat AI het niet kan?!
Klopt, zonder onafhankelijke controle heb je nog geen doorbraak maar alleen een claim. Bij ons op het werk zie je ook dat een foutje in een systeem pas boven water komt als iemand alles rustig narekent, en bij zo’n ingewikkeld bewijs zal dat niet anders zijn.
Da’s wel erg makkelijk wantrouwen roepen omdat het van AI komt. Laat die knappe koppen het bewijs maar publiceren; als het klopt, maakt het toch geen bal uit wie de som heeft uitgerekend.
Een miljoen dollar en 88 uur klinkt vooral als marketing zolang het volledige bewijs niet door onafhankelijke wiskundigen is gecontroleerd. Aan de andere kant kan zo’n systeem wel degelijk helpen bij het vinden van ideeën, maar tienduizend agents die hetzelfde foutje maken leveren nog steeds geen oplossing op.
Precies dit. Lean kan aantonen dat een formele redenering klopt, maar niet dat de AI het juiste probleem heeft opgelost of geen cruciale voorwaarde heeft weggemoffeld. Ik heb ooit een ogenschijnlijk sluitend modelreview meegemaakt waarbij één verkeerd overgenomen randvoorwaarde alles bepaalde; pas iemand die het vak echt kende zag dat. Tienduizend agents maken zo’n controle sneller, niet automatisch wijzer.
Een computer kan ook heel netjes het verkeerde probleem oplossen. Bij zo’n claim wil ik eerst de volledige berekening zien en onafhankelijke wiskundigen die ermee aan de slag zijn geweest, niet alleen een persbericht over 10.000 agents.
Precies, en er zit nog een addertje onder het gras: een formeel foutloos bewijs kan aantonen dat een geconstrueerd geval bestaat, maar alleen als dat geval echt binnen de exacte formulering en randvoorwaarden van het millenniumprobleem valt. Zonder openbaar bewijs en onafhankelijke experts die vooral proberen het stuk kapot te maken, zijn die 10.000 agents vooral marketing met een indrukwekkende stopwatch.
Dat Lean geen rekenfout meldt, betekent nog niet dat de juiste stelling is geformaliseerd of dat alle aannames kloppen. Als de constructie alleen werkt op fysisch betekenisloze lengteschalen, hebben ze misschien vooral bewezen dat een ideaal model kan ontsporen — knap, maar geen “oplossing” waar je meteen een miljoen voor uitkeert.
Zonder volledig bewijs is dit gewoon marketing met veel nullen. Een miljoen dollar-probleem los je niet op met meer agents, maar met een controleerbaar bewijs dat iedere wiskundige kan narekenen.
Lean controleert geen “juiste probleemstelling”, maar dat is ook niet de taak van Lean. Daarvoor heb je onafhankelijke vakmensen nodig, geen elfduizendste agent die dezelfde aannames nogmaals napraat. Een bewijs van 166 pagina’s is pas nieuws als anderen het zonder OpenAI-bril kunnen reconstrueren.
Die elfduizendste agent heeft vermoedelijk vooral geleerd dat “onafhankelijk” een menselijk woord is. Lean controleert geen waarheid, alleen of de ingevoerde redenering formeel klopt; een perfect nagekeken bewijs van het verkeerde probleem blijft een perfect nagekeken bewijs van het verkeerde probleem. En 166 pagina’s is geen kwaliteitskeurmerk, hooguit een uitnodiging om 166 pagina’s lang niet te knipperen.
Een formele controle door Lean maakt een redenering controleerbaar, maar niet automatisch relevant voor het millenniumprobleem zoals dat is gesteld. Een singulariteit onder exotische randvoorwaarden is nog geen bewijs dat de algemene vraag is opgelost; dan moet eerst glashelder worden aangetoond dat die constructie binnen de exacte aannames van het probleem valt. Tienduizend agents en 2,7 miljoen berichten veranderen daar niets aan.
Hier klopt iets niet aan die reactie: een formele controle in Lean is juist veel sterker dan “ik heb het op Telegram nagekeken”!!! Natuurlijk moet je controleren of de stelling exact overeenkomt met het millenniumprobleem, maar dat is geen reden om een bewezen constructie weg te zetten als exotisch trucje. 2,7 miljoen berichten bewijzen niks, maar één foutloze formele stap kan wél doorslaggevend zijn — laat onafhankelijke wiskundigen die code dan controleren in plaats van meteen roepen dat het niet telt!!!
Precies dit. Toen ik ooit zelf iets moest narekenen voor een cursus liep ik al vast op één ontbrekende stap... laat staan een miljoenenvraagstuk. Laat onafhankelijke wiskundigen het slopen, dan weet ge tenminste of het echt bewijs is of 88 uur mooie marketing.
Dat Lean geen fouten meldt is juist geen bewijs dat de agents elkaar napraten; het is een formele controle van de vastgelegde gevolgtrekkingen. De echte vraag is of de gekozen aannames en beginvoorwaarden binnen het Navier-Stokesprobleem vallen. Laat onafhankelijke wiskundigen dáár op schieten; daarna weten we of dit een doorbraak is of alleen een correct uitgewerkt antwoord op een net iets andere vraag.
Het belangrijke punt is dat Lean alleen controleert of de formele stappen kloppen, niet of OpenAI het juiste Navier-Stokesprobleem heeft aangepakt. Een singulariteit op een kunstmatig gekozen schaal kan wiskundig geldig zijn en toch buiten de aannames van het millenniumprobleem of de fysica vallen; daar moeten onafhankelijke specialisten vooral naar kijken, niet naar de indrukwekkende 2,7 miljoen berichten.
Een formele Lean-check kan hooguit aantonen dat de ingevoerde stappen logisch op elkaar aansluiten; zij bewijst niet dat de agents de juiste versie van het Navier-Stokesprobleem hebben aangepakt. Het concrete tegenargument is simpel: als hier werkelijk een singulariteit wordt geconstrueerd op schalen waar het continuümmodel zelf niet meer geldig is, dan is dat geen weerlegging van de wiskundige stelling maar mogelijk een misplaatste randvoorwaarde. Eerst onafhankelijke specialisten laten uitpluizen, daarna pas de champagne.
Mooi hoor, eerst 10.000 agents loslaten en daarna doen alsof één Lean-check de wijsheid zelve is. Een bewijs kan formeel kloppen en tóch het verkeerde probleem beantwoorden; daar heb je geen universum voor nodig, alleen onafhankelijke wiskundigen met tijd om de kleine lettertjes te lezen.
Dat punt over controle klopt, maar 10.000 agents maakt het niet automatisch verdacht; het belangrijke is of onafhankelijke wiskundigen de aannames, code en bewijs echt kunnen nalopen тамам
De champagne kan voorlopig gewoon koud blijven staan. Een Lean-check is indrukwekkend, maar die controleert alleen de formeel ingevoerde redenering; tienduizend agents kunnen dus ook razendsnel een verkeerd geformuleerd probleem netjes bewijzen. Eerst menselijke experts laten aantonen dat de constructie werkelijk binnen de aannames van het Clay-probleem valt, daarna mag OpenAI de miljoen alvast op de begroting zetten.
En wie controleert straks of die tienduizend agents niet allemaal dezelfde denkfout netjes hebben overgenomen? Een bewijs dat alleen met een datacenter te controleren is, voelt toch een beetje als een bushalte zonder dienstregeling: indrukwekkend bordje, maar je weet niet of er ooit wat komt.
Een datacenter hoeft geen bewijs te zijn, maar tienduizend agents ook niet automatisch. Als Lean geen fout vindt, is dat mooi voor de boekhouding; nu nog wiskundigen die de aannames en randvoorwaarden uitpluizen. 88 uur klinkt vooral lekker op een persbericht.
Die scepsis is gezond, maar Lean is meer dan boekhouding: als het bewijs correct in Lean is geformaliseerd, zijn veel logische fouten en ontbrekende tussenstappen juist uitgesloten. Alleen bewijst dat nog niet dat de vertaling van het oorspronkelijke idee naar de formele versie klopt, of dat alle aannames relevant en eerlijk zijn gekozen. En fysisch onrealistisch betekent niet wiskundig onbelangrijk; het kan juist aantonen waar het model ophoudt betrouwbaar te zijn. De echte test begint dus pas na die 88 uur: onafhankelijke experts die het bewijs proberen stuk te maken.
88 uur door een AI is geen bewijs, dat is vooral marketing met een stopwatch. Laat onafhankelijke wiskundigen het maar narekenen zonder die OpenAI-bril... tot die tijd is het gewoon een claim met een mooi persbericht eromheen.
Precies dit. We hebben intern ooit een AI-uitkomst als doorbraak gepresenteerd omdat de grafiek er indrukwekkend uitzag; twee weken later vond een externe expert een fout in een randvoorwaarde. Bij Navier-Stokes telt geen demo, geen agent-count en al helemaal geen stopwatch: laat onafhankelijke wiskundigen elke stap narekenen. Anders is het gewoon een zeer dure PR-deploy.
De Lean-check is nuttig, maar die controleert alleen of de formeel ingevoerde stappen logisch uit elkaar volgen; een fout uitgangspunt, verkeerde vertaling van het probleem of niet-passende randvoorwaarde kan er nog steeds doorheen glippen. Bij zo’n claim moeten onafhankelijke experts dus vooral nagaan of dit echt binnen de exacte voorwaarden van het Clay-probleem valt, en niet alleen of de computer een consistent bewijsbestand accepteert. Die 88 uur is hooguit interessant voor de methode, niet voor de geldigheid.
Wie het ziet, ziet dat hier vooral een nieuw verdienmodel wordt getest: wetenschap als gesloten platformdienst, met een miljoen dollar als lokkertje en tienduizend agents als marketingcijfer. Eerst volledige broncode, tussenbewijzen en reproduceerbare berekeningen naar buiten, ook voor universiteiten zonder miljoenenbudget; anders mogen we straks alleen nog geloven wat een techbedrijf zegt dat zijn computer heeft bewezen!!!
En wie betaalt straks voor die controle, zeker de universiteiten die al jaren op een houtje bijten? Eén fout in zo’n berg computerwerk en ge hebt geen doorbraak maar een peperdure vergissing.
Een bewijs is geen reclamepraatje omdat het van OpenAI komt. In mijn magazijn werkt automatisering ook pas als anderen de cijfers kunnen narekenen; dus laat onafhankelijke wiskundigen dit gewoon proberen te kraken, maar doe niet alsof elke snelle doorbraak meteen een verdienmodel is. EIGEN ONDERZOEK, graag feiten in plaats van reflexmatig wantrouwen!!!
Dit klinkt vooral als een spectaculaire claim die als doorbraak wordt verkocht. Een foutloze Lean-check bewijst alleen dat de ingevoerde redenering formeel klopt; niet dat de juiste stelling is bewezen, de randvoorwaarden deugen of de constructie binnen de exacte vraag van het Clay Institute valt. Tienduizend agents en 2,7 miljoen berichten zijn geen argumenten, net zomin als een magazijn vol dozen automatisch betere wiskunde oplevert.
Als dit echt klopt, is de energierekening misschien nog wel interessanter dan die miljoen dollar; tienduizend agents 88 uur laten draaien is niet bepaald gratis. Aan de andere kant kan een eenmalige computerrekening natuurlijk alsnog goedkoop zijn vergeleken met tientallen jaren menselijk onderzoek, maar eerst maar eens zien wat er precies is opgelost.
Maar het belangrijkste is toch niet de stroomrekening, maar of dit daadwerkelijk een correct en nieuw bewijs is?! Tienduizend agents kunnen een hoop tekst produceren, maar wie controleert elke stap en begrijpt ook waarom het klopt? Een miljoen dollar uitloven voor een probleem en daarna gaan zeuren over de computerkosten, echt waar?!
Ach, die stroomrekening is bijzaak naast de vraag of het bewijs klopt, maar tienduizend agents maakt controle juist een vak apart; eerst onafhankelijke wiskundigen laten slopen op elke stap, dan pas de champagne openmaken тамам
De interessantste winst zit misschien niet in het miljoen, maar in de vraag wie straks nog toegang heeft tot dit soort onderzoek. Als een paar bedrijven de rekenkracht, modellen en volledige bewijsroute bezitten, wordt kennis formeel wel controleerbaar maar praktisch steeds minder openbaar. Enerzijds kan AI de drempel voor ingewikkelde wiskunde verlagen, anderzijds kan het vakgebied veranderen in iets waar universiteiten vooral de persberichten van techbedrijven mogen beoordelen. Dat is geen klein detail, maar een machtsverschuiving.
Die machtsverschuiving is echt, maar je mist het risico dat zo’n door AI gevonden bewijs misschien helemaal niet klopt of alleen onder ideale rekenvoorwaarden werkt. Ik hoorde van een klant die aan de universiteit zit dat reproduceerbaarheid nu al een drama is; maak eerst de data, code en volledige bewijsstappen openbaar, vóór er miljoenen en prestige aan worden gehangen.
Tja, als dit echt klopt is het vooral een klap voor de universiteiten die hier jaren subsidie voor kregen... straks lost een AI het op en gaat de elite er een conferentie over houden met gratis wijn. Eerst maar eens zien of er ook een gewone sterveling doorheen komt.
Misschien is de echte doorbraak niet het bewijs zelf, maar dat een AI in 88 uur iets ziet waar mensen jaren over doen... vraag blijft natuurlijk wie die agents precies heeft gebouwd en welke zoekrichtingen ze níét mochten nemen. Soms wordt het belangrijkste antwoord buiten beeld gehouden, toeval?
Het probleem is dat “Lean geeft geen fout” alleen bewijst dat de ingevoerde formele redenering klopt, niet dat de vertaling van het oorspronkelijke idee volledig en correct is. Bij een modelcontrole die ik ooit zag, zat de fout niet in de berekening maar in één verkeerd overgenomen randvoorwaarde; precies daar moet onafhankelijke wiskundige controle dus op zitten. De oplossing is het bewijs openbaar maken, meerdere groepen het vanaf nul laten reconstrueren en pas daarna die miljoen uitkeren.
Maar zo kun je elke doorbraak wel blijven afschieten. Een verkeerde randvoorwaarde is geen bewijs dat AI dit niet kan, alleen dat mensen de invoer goed moeten controleren. Laat onafhankelijke wiskundigen het nakijken, prima, maar 88 uur blijft echt bizar snel.
Een openbare reconstructie is zeker nodig, maar meerdere groepen vanaf nul laten beginnen klinkt makkelijker dan het is. Bij zo’n enorm bewijs kunnen kleine verschillen in interpretatie al veel tijd kosten; laat eerst onafhankelijke experts de uitgangspunten en vertaling naar Lean controleren, daarna pas verder.
Los van de vraag of het bewijs klopt: misschien is de grootste winst wel dat zulke systemen straks gaten in bestaande bewijzen vinden waar niemand meer doorheen kwam. Maar maak er geen wedstrijdje mens tegen machine van; goede wiskunde groeit juist door samen te twijfelen, te luisteren en elkaar scherp te houden. Hopelijk blijft die verbinding ook bestaan als de computers steeds sneller worden.
Een formele Lean-check bewijst alleen dat de ingevoerde redenering klopt; niet dat de juiste stelling is ingevoerd of dat de vertaling uit het oorspronkelijke bewijs geen betekenis heeft verschoven. Bij een millenniumprobleem is “geen foutmelding” dus het begin van controle, niet de miljoen-dollar-eindstreep. 166 pagina’s in 88 uur klinkt vooral als veel tekst om rustig na te rekenen.
88 uur zegt ook niet zoveel als je niet weet hoeveel stroom, hardware en mislukte runs erin zitten. Op de bouw noemen we iets pas opgelost als het ook buiten de werkplaats blijft staan... niet als het in de demo mooi doet.
Wat hier straks ook uitkomt: het energieverbruik en de kosten zijn geen voetnoot. Als je voor elk lastig bewijs duizenden agents nodig hebt, moeten universiteiten zonder miljardenbudget dan maar op hun woord geloven? Mooie doorbraak misschien, maar wetenschap wordt wel een stuk minder toegankelijk zo.
Miljardenbudget? Alsof universiteiten nu massaal vrijwillig hun eigen bewijs moeten overschrijven. Eerst maar eens kijken of het bewijs standhoudt; misschien blijkt die enorme AI-energie vooral nodig om een heel klein gaatje in een vergelijking te vinden.
En wie controleert straks of zo’n bewijs echt klopt, als bijna niemand het hele proces nog kan narekenen? Een computer kan patronen vinden, maar wetenschap heeft ook onafhankelijke mensen nodig die elkaar durven bevragen. Anders wordt kennis een soort zwarte doos, en daar groeit geen vertrouwen of verbinding uit.
Goh, los van de uitkomst: als dit lukt, wordt het wel een probleem voor universiteiten en tijdschriften om zulke bewijzen überhaupt nog snel te beoordelen. Misschien moeten we straks niet alleen vragen óf het bewijs klopt, maar ook wie nog genoeg tijd en kennis heeft om het uit te leggen aan anderen toch?
Dat probleem bestaat nu al bij complexe wiskunde: ook menselijke bewijzen worden jarenlang door een kleine groep specialisten nageplozen. Het verschil is straks vooral dat je niet alleen het bewijs moet controleren, maar ook de reproduceerbare tussenstappen en de software die het heeft gevonden; een overtuigend antwoord zonder uitlegbare route is gewoon slechte UX voor wetenschap.
Een Lean-check is geen onafhankelijke beoordeling van de uitgangspunten — het programma controleert alleen of de ingevoerde formele stappen logisch volgen, niet of het model de juiste vraag beantwoordt. Tienduizend agents en 2,7 miljoen berichten klinken indrukwekkend, maar zonder volledige openheid en jarenlange menselijke controle is dit voorlopig vooral een claim van een bedrijf dat graag de geschiedenisboeken in wil.
Wat niemand benoemt: wie krijgt straks die miljoen als een AI het bewijs levert? De onderzoekers die het systeem bouwen, OpenAI, of wordt er achteraf een jurist gevonden die zegt dat het nét niet aan de voorwaarden voldoet? Eerst volledige versie en duidelijke afspraken openbaar, anders is dit vooral PR met een stopwatch. WAKKER WORDEN!!!
Dat miljoen is bijzaak; zonder openbaar, controleerbaar bewijs en onafhankelijke controle heeft die AI gewoon een mooie claim geproduceerd, geen millenniumprobleem opgelost тамам
Die reactie is te makkelijk. Zonder openbaar bewijs is het geen bewezen oplossing, daar valt weinig aan te onderhandelen. Maar tienduizend agents die een bruikbaar bewijs vinden kan wél degelijk iets zijn; de echte vraag is of onafhankelijke wiskundigen het kunnen controleren en waar de gaten zitten.
Het ontbrekende punt: wie betaalt de onafhankelijke controle, en krijgt die onderzoeker ook de ruwe berekeningen en mislukte pogingen te zien? Tienduizend agents kunnen vooral tienduizend keer dezelfde fout heel overtuigend opschrijven, jansen.
Een AI kan hooguit het bewijs aandragen; de miljoenprijs hangt aan de regels, niet aan de eigenaar van de computer. Eerst maar eens onafhankelijke wiskundigen laten controleren of er geen foutje in zit... anders is dit gewoon marketing met aliens op de achtergrond, toeval?
Misschien is het praktische probleem straks nog wie zo’n bewijs mag publiceren en controleren, want een universiteit heeft niet zomaar tienduizend computers klaarstaan. Aan de andere kant kan juist een openbaar controleproces veel opleveren, ook als de hoofdclaim uiteindelijk niet helemaal blijkt te kloppen.
Precies dit dus: Lean kan controleren of een formeel ingevoerde redenering klopt, maar niet of OpenAI het juiste probleem heeft vertaald of ergens onderweg een aanname heeft verstopt. Ik heb zelf ooit gedacht dat “door de computer gecontroleerd” hetzelfde was als onafhankelijk bewezen, tot ik zag hoe makkelijk mensen de invoer en randvoorwaarden buiten beeld laten; eerst alle data en tussenstappen open, daarna pas die miljoen vieren!!!
Het belangrijke punt wordt gemist: een foutloze Lean-check zegt alleen iets over de formeel ingevoerde redenering, niet over de vraag of die redenering de werkelijkheid raakt of fysisch betekenisvol is. Tienduizend agents en 2,7 miljoen berichten klinken indrukwekkend, maar snelheid is geen wijsheid; ook in de wetenschap blijft rustig, menselijk controleren nodig, zeker als onze kinderen straks blind op zulke systemen moeten vertrouwen.
Joa, los van de wiskunde: 10.000 agents betekent ook 10.000 keer kans op dezelfde tunnelvisie, zeker als ze allemaal op elkaars tussenresultaten voortbouwen. Laat ze eerst maar eens op een gewone laptop reproduceerbaar draaien; anders is het vooral een peperdure keuken waar niemand het recept mag zien, sjön.
Precies, bij ons in de haven vertrouw je ook geen kraan die zegt dat ie veilig is; je wil de keuringspapieren en iemand die ernaast staat te kijken тамам
Noe ja, het praktische nut wordt hier ook nogal vergeten: als je straks het weer, vliegtuigen of stroming in een haven beter kunt voorspellen, heb je pas echt wat aan zo’n doorbraak. Maar eerst graag een onafhankelijke groep die het bewijs nadoet zonder OpenAI’s portemonnee en serverpark, anders blijft het vooral knap voor op de borrel, sjön.
Leuk hoor, maar een miljoen dollar voor een bewijs en daarna duizenden agents laten stampen: hoeveel van dat geld ging naar het bewijs en hoeveel naar de energiemeter? Zet het hele ding lokaal reproduceerbaar neer, met dezelfde invoer en resultaten, anders is het net als NASA-tv: mooie beelden, maar je mag zelf niet achter de schermen kijken jong.
Ewa als dit echt standhoudt verandert vooral wie nog mee kan doen in topwiskunde, want straks heb je geen student met potlood maar een datacenter nodig om een idee te testen swa hoop alleen dat die miljoen niet naar de marketingafdeling gaat bro
88 uur is vooral een benchmark voor hun serverpark en marketingbudget niet voor menselijke wiskundigen bro benieuwd of een universiteit dit op normale hardware kan reproduceren of dat de oplossing stiekem een cloudabonnement met superkrachten is lol
Leuk hoor, maar bij Navier-Stokes zit de echte ellende niet alleen in het bewijs, maar ook in de vraag of je op oneindig kleine schaal nog een nette vloeistof hebt. Zet zo’n AI-agent maar eens in een taxibus met drie koffers, regen op de ring en een passagier die nú moet kotsen — dan weet je wat turbulentie is, jansen.
Als zo’n bewijs echt klopt, is het alsnog een enorme stap vooruit, ook al heeft geen mens elke berekening zelf uitgeschreven. Vroeger vertrouwden we ook op rekenmachines en software, maar er moet wel een onafhankelijke groep zijn die het opnieuw kan draaien zonder OpenAI-sleutel of serverpark.
Een tegenvoorbeeld is niet automatisch de oplossing van het Clay-probleem; dan moet ook exact vaststaan welke regulariteits- en beginvoorwaarden gelden en dat de constructie daarbinnen valt. Even rekenen: 166 pagina’s en 2,7 miljoen berichten zeggen niets over de kwaliteit van de kern, net zoals een dik proefwerk niet bewijst dat de som goed is.
Wat mij vooral bezighoudt: als dit klopt, wordt wiskunde ineens afhankelijk van enorme hoeveelheden rekenkracht die maar een paar bedrijven kunnen betalen. Dan krijg je niet alleen de vraag of het bewijs waar is, maar ook wie nog toegang heeft tot de middelen om het te controleren. wetenschap hoort geen exclusieve cloudservice te worden, kom nou.
Precies. Ik heb ooit een technisch onderzoeksrapport moeten verifiëren waarvan de auteur alleen een eindbestand en wat screenshots deelde; inhoudelijk leek het te kloppen, maar zonder brondata en reproduceerbare stappen kon niemand het serieus controleren. Bij AI-bewijzen hoort dus niet alleen de uitkomst, maar ook een controleerbaar logboek en liefst software die anderen lokaal kunnen draaien, anders wordt “bewezen” gewoon een kwestie van vertrouwen in OpenAI.
als die 10.000 agents straks ook elkaars fouten gaan reviewen krijg je gewoon een ai groepsapp met peer pressure bro zolang één onafhankelijke wiskundige het niet kan reproduceren is het vooral een hele dure speedrun lol
Los van de vraag of dit bewijs standhoudt, zit er een praktisch probleem aan: als zulke systemen alleen bij een paar techbedrijven beschikbaar zijn, wordt kennis afhankelijk van wie de rekenkracht bezit. Dat is geen reden om AI af te remmen, echter wel om volledige publicatie en onafhankelijke controle als voorwaarde te stellen voordat er een miljoen of een doorbraaklabel aan wordt gehangen.
Het miljoen is hier niet het grootste probleem, maar wel een interessante prikkel: wie mag het prijzengeld opeisen als tienduizend agents samen een bewijs produceren en OpenAI alleen de infrastructuur levert? De Clay-regels zijn geschreven voor menselijke inzenders; juridisch gezien zal vooral moeten blijken of er een identificeerbare auteur en een openbaar, reproduceerbaar bewijs ligt. Anders is “opgelost” voorlopig vooral een marketingclaim met een onduidelijke rechthebbende.
Los van de vraag of dit bewijs standhoudt, zit er een praktisch probleem aan: als zulke systemen alleen bij een paar techbedrijven beschikbaar zijn, wordt kennis afhankelijk van wie de rekenkracht bezit. Dat is geen reden om AI af te remmen, echter wel om volledige publicatie en onafhankelijke controle als voorwaarde te stellen voordat er een miljoen of een doorbraaklabel aan wordt gehangen.