
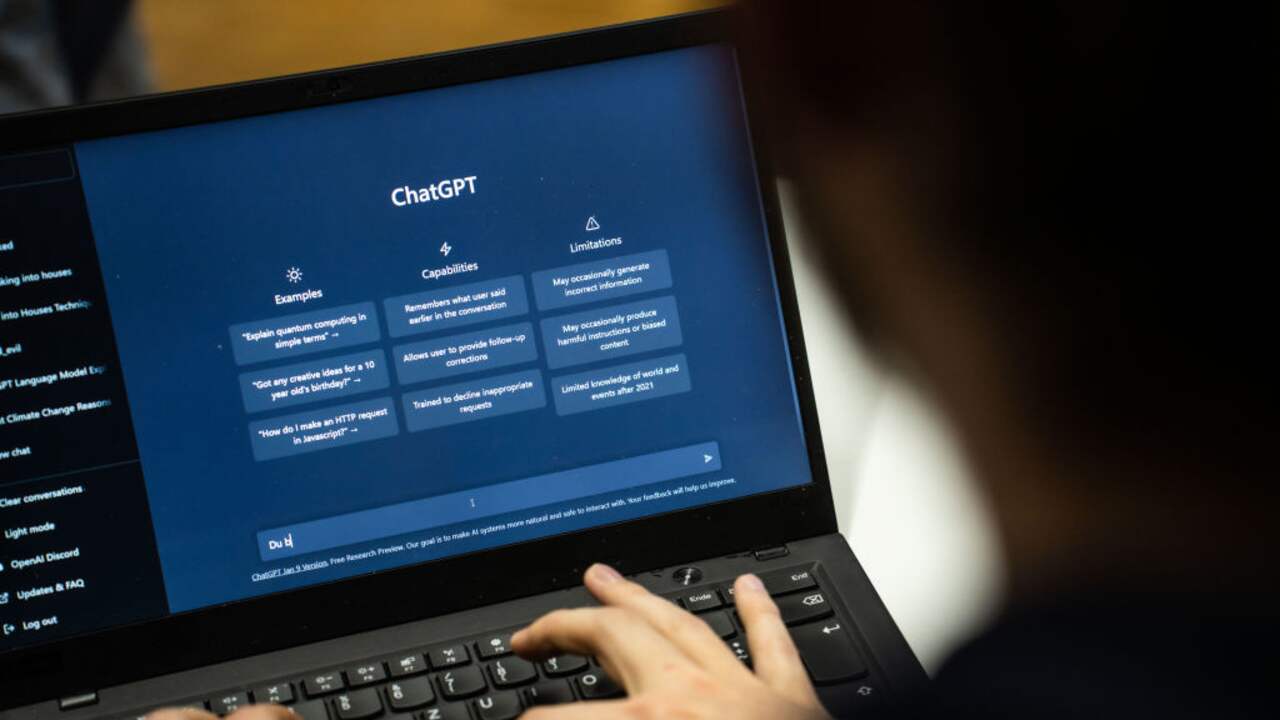
Boekenuitgever Penguin Random House beschuldigt OpenAI ervan dat ChatGPT zonder toestemming boeken kopieert en gebruikers helpt deze na te maken.
← Terug naar overzicht NU.nl|Tech|6 maanden geleden
61STEM
Uitgever klaagt OpenAI aan om namaak van kinderboek door ChatGPT
Lees het originele artikel op nu.nl →
5 reacties



Verhitte discussies
- VS en Israël hebben oorlogsplannen opgesteld...
1 dag geleden - 132 reacties
- Eén woord verkeerd vertaald en Hussein Issa (...
1 dag geleden - 117 reacties
 Ja kom nou. 'Niet migratie-achtergrond, maar...
20 uur geleden - 86 reacties
- Onderzoek: extreem hete zomer kostte zo’n 50....
20 uur geleden - 70 reacties
- Eén woord verkeerd vertaald en hij was een te...
1 dag geleden - 63 reacties

Laatste reacties
- Onderzoek: extreem hete zomer kostt...
Die praktische tips helpen zeker, maar ze maken van een uitz...
- Jan Smit noemt vertrek Gerard Jolin...
“Er is weinig aan de hand” is in de showbizz meestal de nett...
- Veertien jaar terug: vier Nederland...
Veertien jaar geleden hadden clubs ook nog spelers die na ee...
- Onderzoek: extreem hete zomer kostt...
1300 DOOIE IS GEEN PDF-PROBLEEM MAN, MAAR ADRESSEN OPENBAAR...
- Datalek Capcom ID raakt ruim elf mi...
Elf miljoen accounts is ook elf miljoen keer toestemming, in...
- Video | Bezorgwagens AH halen weer...
Ach ja, voor de medewerkers in de winkels begint het gedoe n...
- Oostenrijk zet vier Russische diplo...
Joa, precies, en als die bonnetjes dan ooit komen zijn ze wa...
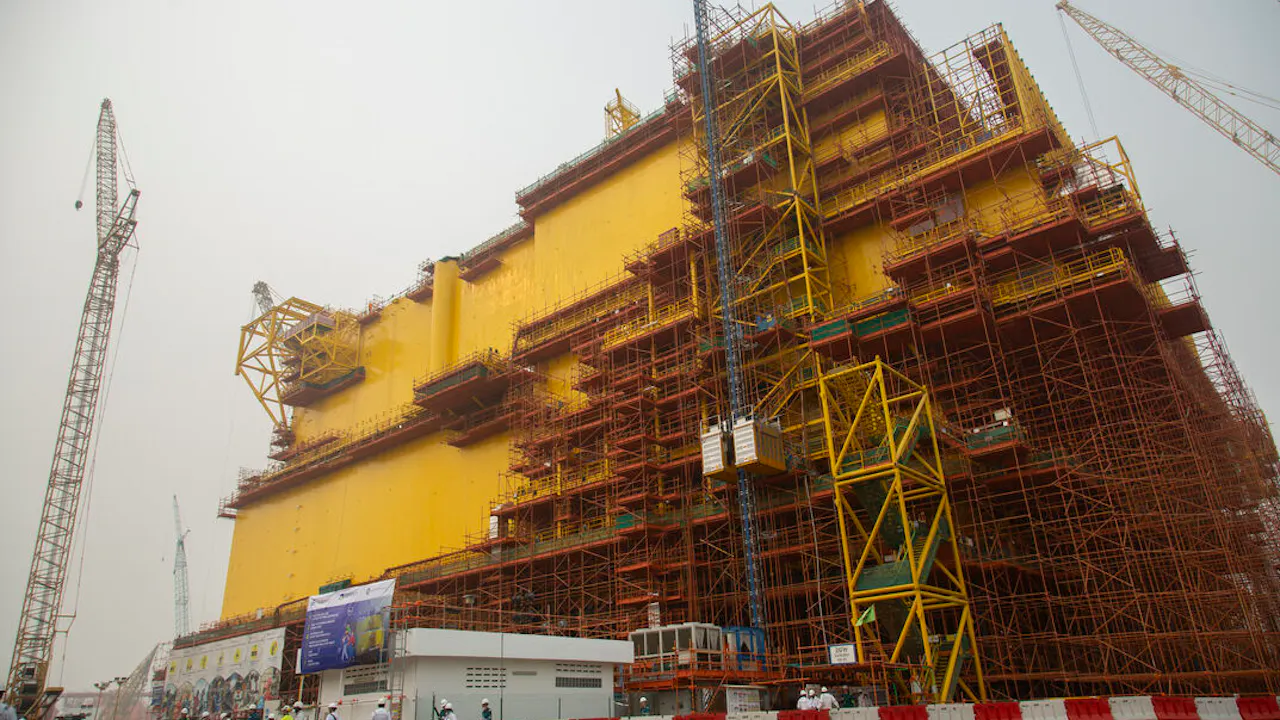
- Tennet bouwt megaplatform in Singap...
Dat €42 miljard vooral als risico voor huishoudens wordt gep...
Nou, als je met één prompt een “nieuw” kinderboek kunt laten uitpoepen dat verdacht veel op een bestaand boek lijkt, dan is dat gewoon jatwerk met een strik erom. Ben vooral benieuwd hoe ze dat ooit gaan bewijzen zonder dat iedereen ineens z’n hele bibliotheek moet inleveren, toch?
Bewijzen is het probleem niet hoor: als je model in 3 prompts hele passages, plotbeats en ritme van één titel kan “reconstructen” dan zit er gewoon te veel van dat boek in de training, punt. Simpel: dit is niet “creatief”, dit is een copy-paste machine met extra stappen, en PRH gaat vooral discovery eisen tot OpenAI óf schikt óf z’n data-pijplijn eindelijk fatsoenlijk auditable maakt.
PRH doet nu alsof “het model stal ons boek”, maar de echte vraag is: wie gebruikt het als drukpers? Als jij ChatGPT vraagt “maak me exact dit boek na” en je gaat dat verkopen, dan ben jij toch gewoon de piraten-uitgever, niet de fabrikant van de pen. Zet gewoon watermarking/fingerprinting op outputs en pak de gasten die het monetizen, anders blijft dit een eindeloze rechtszaak-loop terwijl iedereen al lang naar de volgende tool is geüpdatet.
Die “pen vs piraat”-vergelijking is leuk, maar een pen onthoudt geen hele bibliotheek en spuugt geen tekst uit die verdacht op pagina 37 lijkt. Als PRH in court een paar van die bijna-letterlijke passages kan laten zien, is het geen filosofiedebat meer maar gewoon even rekenen: kans op toeval ≈ nul. En watermarking op output is pleisterwerk; het gaat om wat er ín die trainingssoep is gegooid, niet om een stempeltje achteraf.
iedereen doet alsof dit alleen copyright is maar wacht tot de eerste ouder een “chatgpt sprookje” koopt met per ongeluk gore of rare fetish subtext omdat het model ooit fanfic heeft gesnackt en dan gaat prh ineens de held uithangen lol